从 LLVM IR 到 LC-3 汇编
一个 Pass 的取舍记录
项目地址:https://github.com/tofucurd/LLVMIRToLC3Pass
大一下写的一个东西:把 C 编译到 LC-3,一门只有八个寄存器、ALU 只有 AND/ADD/NOT 的 16 位教学指令集。起因是 ECE 220 的 Assembly 作业,写完之后用它跑完了全部 Assembly MP。
为什么是 Pass,而不是 Backend
LLVM Backend 框架比较复杂,虽然已经有像 TableGen 这种尝试减轻难度的部分,但是依旧门槛比较高。而对于 LC-3 这种 educational 的架构,局限性比较大,甚至不可能真正做到 full C compatible,比如纯 16 位系统,不支持按字节寻址,不支持除 16 位外的计算,ALU 只支持 AND、ADD、NOT,load/store register offset 只能支持到 [-32, 31],普通分支只能跳到 ±256 个字以内,子程序调用也只有 ±1024 个字等等原因。所以,LC-3 注定无法承担稍微大一点的程序,因此使用 LLVM Pass 翻译 LLVM IR 成了最合理也最方便的选择。
LC-3 Calling Convention
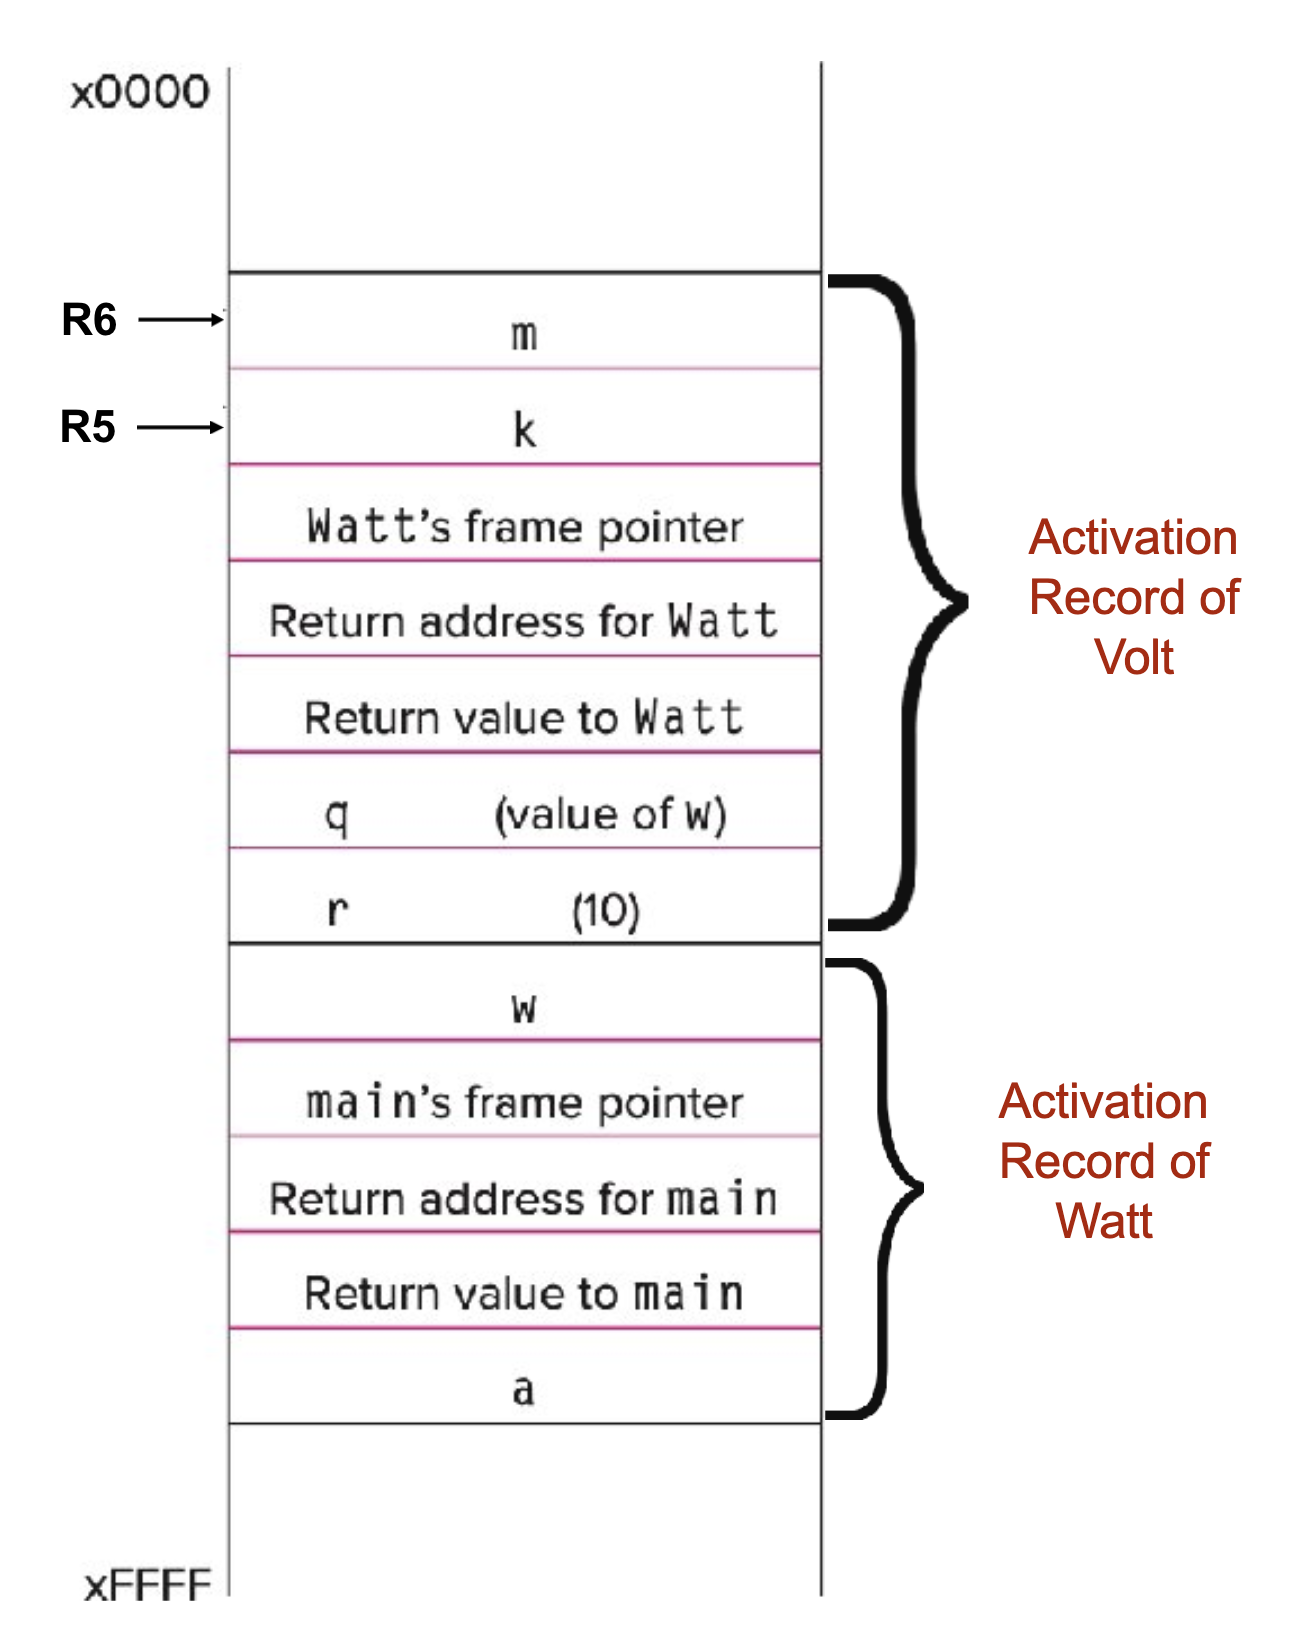
为了统一和便于理解,LC-3 使用纯栈传递参数和返回值,R5 为 fp,R6 为 sp,且栈由高位(最高 0xFE00)向低位生长,R7 为 return address,均为 Callee saved。由于 LC-3 仅支持 16 位数据,因此并无 BE 和 LE 的区别,stack frame 如下图所示(Watt 为 Caller,Volt 为 Callee):
总体思路
首先,LC-3 不能支持太大体量的程序,ABI 也只有字符串的输入输出,因此通常只会有一个 LLVM IR Module。因此 LLVMIRToLC3Pass::run() 就以 Module 为参数,以 Block 为子单元进行翻译,不区分 pointer 和 variable,所有 virtual register 都当做 local variable 存在栈里。由于只是一个 LLVM Pass,因此需要手动使用 ToolOutputFile 和 raw_string_ostream 进行输出。主要流程是先对 LLVM IR 进行一些预处理,使之更加适合后续的逐命令翻译,然后逐命令将 LLVM IR 翻译成 LC-3 Assembly,这当中对一些特殊的情况需要额外处理。
技术特点
1. 实现 PHI Node 分支控制流 —— 主要技术难点
PHI node 是 LLVM IR 中重要的分支控制机制,一定位于一个 Block 的第一个命令。与 Block 搭配使用,PHI 可以高效进行复杂的分支跳转和管理。主要难点是,PHI 需要判断当前是由哪一个 Block 跳转而来的。为了解决这个问题,可以创新性地利用 R7 寄存器:在每一个 Block 末尾要 Branch 时,利用 LC-3 的 LEA 指令加载当前 Block 的 LABEL 地址到 R7 里,于是跳转后 PHI 便可以立即从 R7 里获知是从哪里跳转而来的。由于 R7 的两个用途生命周期不会重叠,所以这样不会有冲突的风险。
在 Branch 时利用 LEA 把信息保存在 R7 里:
1
2
3
if (auto *BranchI = dyn_cast<BranchInst>(&I)) {
          FuncInstBufferStream << "\tLEA\t\tR7, " << BBName << "\n";
/*...*/
具体 PHI Node 实现:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
int ResOff = -getIndex(&I, ValueOffsetMap, ValueOffsetCounter);

FuncInstBufferStream << "\tNOT\t\tR0, R7\n"
                     << "\tADD\t\tR0, R0, #1\n";
int ArgSize = PHIN->getNumIncomingValues();
int EndLableID = TempLabelCounter + ArgSize;
for (unsigned int i = 0; i < ArgSize; ++i) {

BasicBlock *SrcBB = PHIN->getIncomingBlock(i);
std::string SrcBBName = getIndex(SrcBB, BBNameMap, BBNameCounter);

++TempLabelCounter;
if (i < ArgSize - 1) {
   FuncInstBufferStream << "\tLEA\t\tR1, " << SrcBBName << "\n"
                        << "\tADD\t\tR1, R1, R0\n"
                        << "\tBRnp\tPHI_NEXT_" << TempLabelCounter
                        << "\n";
}

Value *Val = PHIN->getIncomingValue(i);
if (int ValID = addImmidiate(Val, ImmBufferStream, ImmFlag,
                              ImmIDMap, ImmIDCounter)) {
   FuncInstBufferStream << "\tLD\t\tR1, VALUE_" << ValID << "\n";
} else {
   int ValOff = -getIndex(Val, ValueOffsetMap, ValueOffsetCounter);
   FuncInstBufferStream << "\tLDR\t\tR1, R5, #" << ValOff << "\n";
}

FuncInstBufferStream << "\tSTR\t\tR1, R5, #" << ResOff << "\n";
if (i < ArgSize - 1) {
   FuncInstBufferStream << "\tBR\t\tPHI_NEXT_" << EndLableID << "\n";
}
FuncInstBufferStream << "PHI_NEXT_" << TempLabelCounter << "\n";
}
2. 索引管理
对于所有需要反复使用的对象,如 Block、variable,使用 DenseMap 与对应计数器来构建字典索引,核心是 getIndex。对于 Block,返回的就是编号,方便在 LC-3 Assembly 中标记 LABEL;对于 variable,返回的 Index 刚好就是该变量相对于 R5 的 offset,即 local variable 为正,function argument 为负;对于 immediate value,由于 LC-3 的 imm 字段过于小,所以将所有 immediate value 都存入对应 Block 末尾 BR 后的空间,以 VALUE_<Index> 为 LABEL 进行索引。具体实现:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
int getIndex(Value *Val, DenseMap<Value *, int> &Map, int &Counter) {
  if (Map.count(Val) == 0) {
    if (auto *Arg = dyn_cast<Argument>(Val)) {
      unsigned Index = Arg->getArgNo();
      Map[Val] = -4 - Index;
    } else {
      Map[Val] = Counter++;
    }
  }
  return Map[Val];
}
std::string getIndex(BasicBlock *BB, DenseMap<Value *, std::string> &Map,
                     int &Counter) {
  if (Map.count(BB) == 0) {
    Map[BB] = BB->getParent()->getName().str() + "_" + getBBName(BB) + "_" +
              std::to_string(Counter++);
  }
  return Map[BB];
}
3. 预处理
为了后续翻译方便,先对初始 LLVM IR 进行预处理,主要有以下几项:
- 由于 LLVM IR 有一类
Intrinsic的命令,最常见也必须处理的是 min/max,而 LC-3 并没有对应的东西,所以需要将这种命令转化成CmpInst再进行下一步处理 - 由于 LC-3 没有减法命令,后续一些需要相减的操作如果每次都写一遍取反加一效率会太低,所以在最高频的两个操作
icmp X, C和sub X, C中,提前计算好改成icmp X, -C和add X, -C。注意,改后icmp不再是本来的用法,需要与后续专门设计的翻译逻辑配套,这只是为了翻译方便而在编译阶段做出的预处理,类似constexpr - 一般化特殊命令,比如
br (icmp eq/ne X, C)改成switch;disjoint or改成add - passthrough 一些命令,比如
trunc - 当右移常数位时,直接预计算翻译成
udiv X, (1 << Constant)
4. 翻译二元运算
由于 LC-3 Assembly 只支持 AND、ADD、NOT,所以其他 LLVM IR 运算需要通过软件内嵌的方式做到:
mul:通过循环加实现,默认非负,这样可以节省一点命令shl:通过不断乘 2 实现udiv/urem:通过不断减实现lshr:使用双指针扫描 source 和目标地址的每一位,根据实际位数设置 offset 来延迟写入目标地址- 同时提供
-signed-mul选项,判断负数后再处理
5. IO API
为了能在 C 中进行 IO,内置了一组 IO API,并在 CallInst 时直接检测函数名并内嵌代码,具体可以见 LC3.h。
6. Function Call
Function Call 流程严格遵照 ECE 220 课上讲的 Calling Convention 实现,使用 JSR 进行跳转,因此 PCoffset11 的范围是 −1024..1023 个字,具体实现可以参考源代码。
与 MP11 的 tiny compiler 进行性能对比
从 main 入口到返回之间实际执行的机器指令数,包含栈帧操作、RET 和被调用的库代码,不含启动与返回后的打印。所有成功项都在 LC-3 模拟器上逐条执行,并重放了 PC 与机器码轨迹、核对了返回值。mp11 没有优化开关,pass 则使用 clang -O0 生成的 IR,避免把 clang 的优化算进 lowering 的质量里。
| 测试 | mp11 | 本 pass | 减少 |
|---|---|---|---|
| 模幂:3¹³⁷ mod 1009 | 19,456 | 11,312 | 41.9% |
| 三层嵌套循环 | 34,813 | 26,957 | 22.6% |
| 批量整数平方根(32 组) | 51,172 | 35,668 | 30.3% |
| 布尔分支与标量递推 | 48,854 | 26,316 | 46.1% |
| 合计 | 154,295 | 100,253 | 35.0% |
这个 Pass 的局限
- 帧槽上限 32 个。
LDR/STR的 offset6 是 6 位有符号立即数(−32..31),局部变量都在 R5 下方,所以一个函数最多 32 个槽。 - 函数调用不能太远:
JSR的 PCoffset11 是 −1024..1023 个字。 - 不支持浮点;无符号数按有符号处理。
- 仍然有一些命令没有实现。
关于 AI
这个项目最后两个 commit(main 分支)是拿来当作测试 Codex 的素材的。手搓版本停留在 handwritten 分支,ECE 220 的全部 Assembly MP 都是用那个版本完成的。